13.1 引言

本章的目的是概述条件自回归和本征自回归。这些模型至少可以追溯到 Besag (1974),并且从那时起就被广泛用于模拟离散空间变化。

传统上,条件自回归已用于直接模拟在预定义图形或格结构上观测到的数据的空间依赖性。然后,推理通常基于似然或伪似然技术 (Besag, 1974; K̈unsch, 1987)。最近,条件自回归以模块化方式应用于(通常是贝叶斯)复杂层次模型。尽管确实存在一些替代方案(Breslow 和 Clayton,1993 年;Rue、Martino 和 Chopin,2009 年),但此类推理几乎总是使用马尔可夫链蒙特卡罗 (MCMC) 进行。在本章中,我们将描述最常用的条件自回归和本征自回归。重点将放在空间模型上,但我们还将讨论与自回归时间序列模型的关系。事实上,自回归时间序列模型是条件自回归的特例,探索这种关系有助于培养普通班级的直觉和理解力。

本章不会详细描述如何建立基于条件自回归先验分布的层次模型以及如何使用 MCMC 对其进行分析。有关详细讨论,请参阅 Banerjee、Carlin 和 Gelfand,2004 年;希格登, 2007; Rue and Held,2005 年以及第 14 章。

首先,考虑一个随机向量 X=(X1,…,Xn)\mathbf{X} = ( X_1,\ldots ,X_n) ,其中每个分量都是单变量的。可以很方便地想象每个组件都位于固定位置 i∈{1,…,n}i \in \{1,\ldots ,n\} 。例如,这些测点可以指特定时间点或二维或更高维空间中的特定点,或地理区域中的特定区域。我们现在希望为 X\mathbf{X} 指定一个密度为 p(x)p(\mathbf{x}) 的联合分布。形式的分解

p(x)=p(x1)⋅p(x2∣x1)⋅p(x3∣x1,x2)⋅…⋅p(xn∣x1,x2,…,xn−1)(13.1)p(\mathbf{x}) = p(x_1) \cdot p(x_2|x_1) \cdot p(x_3|x_1,x_2) \cdot \ldots \cdot p(x_n|x_1,x_2,\ldots ,x_{n-1}) \tag{13.1}

当然,总是可能的。在时间上下文中,这种因式分解非常有用,并且——在一个额外的马尔可夫假设下——进一步简化为

p(x)=p(x1)⋅p(x2∣x1)⋅p(x3∣x2)⋅…⋅p(xn∣xn−1)p(\mathbf{x}) = p(x_1) \cdot p(x_2|x_1) \cdot p(x_3|x_2) \cdot\ldots \cdot p(x_n|x_{n-1})

事实上,这种因式分解构成了所谓的一阶自回归模型的基础,并且可以方便地推广到更高阶。然而,在空间上下文中,索引 1,…,n1,\ldots ,n 是任意的并且原则上可以很容易地排列, 式(13.1) 并不是很有帮助,因为很难想象得到以上乘积。给定所有其他测点 j≠ij \neq i 的值 Xj=xjX_j = x_j ,指定完整的条件分布 p(xi∣x−i)p(x_i |\mathbf{x}_{-i}) (即 XiX_i 在特定测点 ii 的条件分布)要自然得多。在空间上下文中,马尔可夫假设指的是条件分布 p(xi∣x−i)p(x_i |\mathbf{x}_{-i}) 仅取决于 x−i\mathbf{x}_{-i} 的几个分量(称为测点 ii 的邻居)的属性。不过,完全条件 p(xi∣x−i),i=1,…,np(x_i |\mathbf{x}_{-i} ), i = 1,\ldots ,n 的集合在什么条件下能够定义有效联合分布并不明显。 Besag (1974) 使用 Brook 展开式(Brook,1964)讨论了存在这种联合分布的基本条件,详情参见 第 12 章。

到目前为止,研究最多的模型是 高斯条件自回归,其中条件分布 p(xi∣x−i)p(x_i |\mathbf{x}_{-i} ) 是单变量的高斯分布,而联合分布 p(x)p(\mathbf{x}) 是多变量高斯分布。 具有马尔可夫性质的高斯条件自回归也称为 高斯马尔可夫随机场 (Künsch, 1979; Rue and Held, 2005)。

本章结构如下:

  • 第 13.2 节 将讨论各种高斯条件自回归。
  • 第 13.3 节 将讨论非高斯条件自回归,例如,二值变量 XiX_i 的自逻辑斯谛模型。
  • 第 13.4 节 转向一种有限制形式的高斯条件自回归 — 本征高斯条件自回归,其在分层模型中具有实际应用。
  • 第 13.5 节 简要介绍了多元高斯条件自回归。

13.2 高斯条件自回归

假设对于 i=1,…,ni = 1,\ldots ,n, Xi∣x−iX_i |\mathbf{x}_{-i} 服从高斯分布,且其条件均值和方差分别为

E(Xi∣x−i)=μi+∑j≠iβij(xj−μj)(13.2)\mathbb{E}( X_i |\mathbf{x}_{-i} ) = \mu_i + \sum_{j \neq i} \beta_{ij}(x_j − \mu_j ) \tag{13.2}

Var⁡(Xi∣x−i)=κi−1(13.3)\operatorname{Var}(X_i |\mathbf{x}_{-i} ) = \kappa^{-1}_i \tag{13.3}

其中, μi\mu_i 通常采用回归形式 (也就是说,与测点 ii 相关的协变量 wiw_i 具有 wi⊤αw^{\top}_i \alpha 的形式)。不失一般性,假设 μ1=…=μn=0\mu_1 =\ldots =\mu_n = 0 。另外,假设对于任意 i≠ji \neq j,有 κiβij=κjβji\kappa_i \beta_{ij} = \kappa_j \beta_{ji}。则上述条件分布对应于一个均值为 0\mathbf{0}、精度矩阵为 Q\mathbf{Q} 的多元联合高斯分布,且精度矩阵 Q\mathbf{Q} 是对称正定矩阵,其元素 Qii=κiQ_{ii} = \kappa_i、Qij=−κiβijQ_{ij} =−\kappa_i \beta_{ij},i≠ji \neq j ,。

这种条件分布的系统称为 自高斯系统 (Besag, 1974)。通常假设精度矩阵 Q\mathbf{Q} 是正则的;不过具有奇异 Q\mathbf{Q} 的高斯条件自回归也很有用,通常被称为 本征自回归,我们将在 第 13.4 节 介绍。在很多应用中,通常只有 XiX_i 的几个 “邻居” 的系数 βij\beta_{ij} 不为零,因此我们用符号 ∂i\partial i 来表示测点 ii 的 “邻居” 集合。这样 式(13.2) 可以被写为(注:假设 μ1=…=μn=0\mu_1 =\ldots=\mu_n = 0 ):

E(Xi∣x−i)=∑j∈∂iβijxj\mathbb{E}( X_i |\mathbf{x}_{-i}) = \sum_{j \in \partial i} \beta_{ij} x_j

这种表达方式强调了 XiX_i 的条件均值仅取决于邻居 ∂i\partial i 。随机向量 X=(X1,…,Xn)⊤X = ( X_1,\ldots ,X_n)^{\top} 将遵循高斯马尔可夫随机场,如 第 12 章 所述。

13.2.1 例子

假设 XiX_i 服从零均值高斯的条件自回归

E(Xi∣x−i)=ϕ{12(x2+xn)fori=112(xi−1+xi+1)for1<i<n12(x1+xn−1)fori=nVar⁡(Xi∣x−i)=κ−1\begin{align*} &\mathbb{E}(X_i | \mathbf{x}_{-i}) = \phi \begin{cases} \frac{1}{2} (x_2 + x_n) & \quad \text{for} \quad i = 1\\ \frac{1}{2} (x_{i-1} + x_{i+1}) & \quad \text{for} \quad 1 < i < n\\ \frac{1}{2} (x_1 + x_{n−1}) & \quad \text{for} \quad i = n \tag{13.4} \end{cases} \\\\ &\operatorname{Var}( X_i |\mathbf{x}_{-i} ) = \kappa^{-1} \end{align*}

其中参数 ϕ∈[0,1)\phi \in [0, 1)。

这乍一看像是一阶自回归时间序列模型,但仔细观察会发现,该模型是一个环状模型,第一个 “时间点” x1x_1 与最后一个 “时间点” xnx_n 之间相互有联系。此模型被称为 循环一阶自回归模型,可被用于分析循环数据。

上例的随机场 X=(X1,…,Xn)⊤\mathbf{X} = ( X_1,\ldots ,X_n)^{\top} 具有如下精度矩阵:

Q=κ2(2−ϕ−ϕ−ϕ2−ϕ−ϕ2−ϕ⋱⋱⋱−ϕ2−ϕ−ϕ2−ϕ−ϕ−ϕ2)(13.5)\mathbf{Q}= \frac{\kappa}{2} \begin{pmatrix} 2 & −\phi & & & & & -\phi\\ −\phi & 2 & −\phi & & & &\\ & −\phi & 2 & −\phi & & &\\ & & \ddots & \ddots & \ddots & &\\ & & & −\phi & 2 & −\phi & \\ & & & & −\phi & 2 & −\phi\\ −\phi & & & & & −\phi & 2 \tag{13.5} \end{pmatrix}

矩阵中其他空白处的元素均为零。精度矩阵 Q\mathbf{Q} 是一个循环矩阵,其基为 d=κ⋅(1,−ϕ/2,0,…,0,−ϕ/2)⊤\mathbf{d} = \kappa \cdot (1, −\phi/2, 0,\ldots, 0, −\phi/2)^{\top} ( 即 Q\mathbf{Q} 的第一行,参见 Rue 和 Held , 2005, Sec. 2.6.1) 介绍的循环矩阵)。

需要注意的是:X\mathbf{X} 的协方差矩阵 Σ=Q−1\boldsymbol{\Sigma} = \mathbf{Q}^{-1} 也是一个循环矩阵。它的基 e\mathbf{e} 等于 X\mathbf{X} 的自协方差函数,可以使用关于 d\mathbf{d} 的离散傅里叶变换 DFT( d\mathbf{d} ) 进行计算,

e=1nIDFT(DFT(d)−1)\mathbf{e}= \frac{1}{n} \quad \text{IDFT}(\text{DFT}(\mathbf{d})^{-1})

此处 IDFT 表示逆离散傅里叶变换,幂函数要按元素来理解。有关推导请参见 Rue 和 Held (2005)。

以下 R 代码为 n=10n = 10 、ϕ=0.9\phi = 0.9 和 κ=1\kappa = 1 的循环精度矩阵计算了相应的协方差矩阵基 e\mathbf{e}。注意,离散傅里叶变换使用了函数 fft() 且函数值的虚部等于零。

code01

从协方差基 e\mathbf{e},可以很容易地导出 X\mathbf{X} 的自相关函数。 图 13.1 左侧显示了 n=100n = 100 和 ϕ=0.9、0.99、0.999、0.9999\phi = 0.9、0.99、0.999、0.9999 时的自相关函数。当然,自相关函数必须是对称的,例如 x1x_1 和 x3x_3 之间的相关性必须与 x1x_1 和 x99x_{99} 之间的相关性相同。对于两个较小的 ϕ\phi 值,在 n/2=50n/2 = 50 的滞后附近自相关基本上为零。对于非常接近 11 的较大 ϕ\phi 值, x\mathbf{x} 的任意两个分量之间存在显著自相关。

fig13.01

将上述自相关结果与普通一阶自回归过程(有向的自回归定义)进行比较是有意义的:

Xi∣xi−1∼N(αxi−1,κ−1)(13.6)X_i |x_{i−1} \sim \mathcal{N}(\alpha x_{i-1}, \kappa^{-1}) \tag{13.6}

上面的一阶自回归过程式中的 ∣α∣<1|\alpha| < 1 以确保平稳性。除了 X1X_1 和 XnX_n 之间缺少链接外,此模型基本与上面讨论的循环一阶自回归模型具有相同的邻居结构。滞后 kk 对应的自相关函数值为 ρk=αk\rho_k = \alpha^k 。

此有向定义能够导出如下完全条件分布:

Xi∣x−i∼{N(αx2,κ−1)i=1N(α1+α2(xi−1+xi+1),(κ(1+α2))−1)i=2,…,n−1N(αxn−1,κ−1)i=nX_i |\mathbf{x}_{-i} \sim \begin{cases} \mathcal{N}(\alpha x_2, \kappa^{-1}) & i = 1\\ \mathcal{N} \left( \frac{\alpha}{1 + \alpha^2} (x_{i-1} + x_{i+1}) , (\kappa(1 + \alpha^2))^{-1} \right ) & i = 2,\ldots ,n−1\\ \mathcal{N}(\alpha x_{n-1}, \kappa^{-1}) &i = n \end{cases}

如果希望对循环自回归模型( 式(13.4) )与普通自回归模型( 式(13.6) )进行比较,则需要使完全条件分布的自回归系数相等。由 ϕ/2=α/(1+α2)\phi /2 = \alpha/(1 + \alpha^2) 可知,给定循环自回归模型的自回归系数 ϕ\phi 时,对应的普通一阶自回归过程系数是 ϕ\phi 的函数:

α(ϕ)=1−1−ϕ2ϕ(13.7)\alpha(\phi) = \frac{1 − \sqrt{ 1 − \phi^2}}{\phi} \tag{13.7}

例如, ϕ=0.99\phi = 0.99 对应 α≈0.87\alpha \approx 0.87 , ϕ=0.999\phi = 0.999 对应 α≈0.96\alpha \approx 0.96 。这表明: 无向高斯条件自回归的系数与有向高斯自回归的系数具有完全不同的含义。

图 13.1 比较了系数为 ϕ\phi 的循环自回归模型的自相关函数与系数为 α(ϕ)\alpha(\phi ) 的普通自回归模型的相应自相关函数。对于 ϕ=0.9\phi = 0.9 和 ϕ=0.99\phi = 0.99 ,可以看到自相关的密切对应高达滞后 5050 。循环模型滞后 n/2n/2 的自相关与普通模型的相应差异分别不超过 4.5e−114.5e − 11 和 0.000720.00072 。对于 ϕ=0.999\phi = 0.999 和 ϕ=0.9999\phi = 0.9999 ,自相关随滞后增加的衰减不如普通自回归模型的几何衰减明显。这是由于循环模型中 xnx_n 和 x1x_1 之间的链接的影响越来越大

13.2.2 规则网格上的高斯条件自回归

现在假设条件自回归模型定义在具有 n=n1n2n = n_1 n_2 个节点的网格上,并让 (i,j)(i, j) 表示第 ii 行第 jj 列中的节点。在网格的内部,可以定义 (i,j)(i, j) 最近的四个点作为其邻居,即节点

(i−1,j),(i+1,j),(i,j−1),(i,j+1)(i − 1,j) , (i + 1,j), (i, j − 1), (i, j + 1)

具有上面这种邻居结构的条件高斯模型通常被称为 一阶自回归(first-order autoregression),其条件均值和条件方差为:

E(Xij∣x−ij)=α(xi−1,j+xi+1,j)+β(xi,j−1+xi,j+1)Var⁡(Xij∣x−ij)=κ−1\begin{align*} &\mathbb{E}(X_{ij}|\mathbf{x}_{-ij}) = \alpha(x_{i-1,j} + x_{i+1,j}) + \beta(x_{i, j −1} + x_{i, j+1}) \\ \tag{13.8} &\operatorname{Var}(X_{ij} | \mathbf{x}_{-ij}) = \kappa^{-1} \end{align*}

式中的 ∣α∣+∣β∣<0.5|\alpha|+|\beta| < 0.5。

在大多数实际应用中, α\alpha 和 β\beta 都是正值。假设网格包裹在一个圆环面( torus )上,则每个网格都有四个相邻网格,此过程是平稳的。环面是具有环形边界条件的规则网格,可以分两步获得。首先,网格被包裹成 “香肠” 。然后,将香肠两端连接起来,使其变成一个环。这个两阶段过程确保每个网格都有四个邻居。例如,网格 (1,1)(1, 1) 将具有四个邻居 (1,2)(1, 2) 、 (2,1)(2, 1) 、 (1,n2)(1,n_2) 和 (n1,1)(n_1, 1) 。有关环面边界条件的进一步说明,参见 图 13.2 和以下示例中的 R 代码。

注意,研究条件自回归的另一种方法是在无限的规则网格上,此时过程将是平稳的并且具有可用的谱密度(详细信息参见 Besag 和 Kooperberg,1995 年;Künsch,1987 年)。

fig13.02

13.2.3 例子

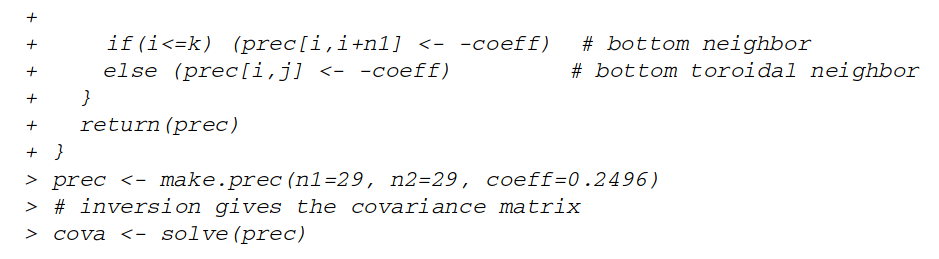
假设在 式(13.8) 的模型中令 α=β=0.2496\alpha = \beta = 0.2496 ,并且定义在大小为 n1=n2=29n_1 = n_2 = 29 的环面上。以下 R 代码计算了 X\mathbf{X} 的自协方差矩阵,其中用到了对精度矩阵的求逆函数 solve()。

另一种方法利用 X\mathbf{X} 的精度矩阵是 块循环 的特点,使用二维傅立叶变换计算自协方差矩阵的基(详细信息参见 Rue 和 Held,2005 年,第 2.6.2 节)。

code01
code02

通过自协方差矩阵,我们可以很容易地计算出任何一对测点之间的自相关。图 13.3 显示了网格 xijx_{ij} , 1≤i,j≤291 \leq i, j \leq 29 与图中心网格 x15,15x_{15,15} 之间的相关性(保留小数点后第一位数字)。虽然系数 α\alpha 和 β\beta 已经接近了参数空间的边界,但相邻网格之间的相关性仅为 0.6690.669 。观察到的最小自相关值出现在 x1,1x_{1,1} 和 x15,15x_{15,15} 之间,其值为 0.1860.186 。

fig13.03

13.3 非高斯条件自回归

对于二值型或计数数据,直接使用高斯条件自回归通常不可行,不过已经提出了一种 logistic(或对数线性)泊松模型形式的条件自回归模型。在本节中,我们将讨论自逻辑斯谛回归模型(autologistic)和自泊松模型(auto-Poisson),它们基本上采用了 式(13.2) 作为 Xi∣x−iX_i |\mathbf{x}_{-i} 的条件均值,不过使用了链接函数,有点类似于广义线性模型(McCullagh 和 Nelder,1990)。不过,一致性要求意味着对于二值型数据只能使用逻辑斯谛链接函数,而对于泊松计数数据只能使用对数链接函数(详细信息参见 Besag,1972 年,1974 年)。只有自逻辑斯谛模型在应用中得到了一定的推广,而自泊松因为具有一些不受欢迎的特性,使其不适用于空间统计中的大多数应用。

13.3.1 自逻辑斯谛模型

假设 Xi,i=1,…,nX_i , i = 1,\ldots ,n 是条件成功概率为 πi(x−i)=E(Xi∣x−i)\pi_i (\mathbf{x}_{-i} ) = \mathbb{E}( X_i |\mathbf{x}_{-i}) 二值随机向量。自逻辑斯谛模型指定了如下条件均值( logit⁡\operatorname{logit} 变换后):

logit⁡πi(x−i)=μi+∑j∈∂iβijxj\operatorname{logit} \pi_i (\mathbf{x}_{-i} ) = \mu_i + \sum_{j \in \partial i} \beta_{ij}x_j

其中 βij=βji\beta_{ij} = \beta_{ji}。出于一致性原因,联合分布的归一化常数(基于 βij\beta_{ij} )非常难以计算,因此用于估计系数的似然方法通常不可行。Besag (1975) 提出了一种 伪似然法,采用最大化条件二项概率乘积的方法。该模型可以推广到具有额外 “样本量” NiN_i 的二项设置。此外,该模型可以扩展到包括协变量(参见 Huffer 和 Wu,1998 年)。

13.3.2 自泊松模型

假设 Xi,i=1,…,nX_i , i = 1,\ldots ,n 是条件均值为 λi(x−i)=E(Xi∣x−i)\lambda_i (\mathbf{x}_{-i} ) = \mathbb{E}( X_i |\mathbf{x}_{-i}) 的泊松随机变量。与自逻辑斯谛模型类似,自泊松模型采用如下方式指定条件均值(对数变换):

log⁡λi(x−i)=μi+∑j∈∂iβijxj\log \lambda_i (\mathbf{x}_{-i} ) = \mu_i + \sum_{j \in \partial i} \beta_{ij}x_j

事实证明,具有指定条件分布的联合分布存在的必要(充分)条件是对于所有 i≠ji \neq j ,有 βij≤0\beta_{ij} \leq 0 。但负系数 βij\beta_{ij} 意味着 ii 和 jj 之间存在负交互作用,意味着 XiX_i 的条件均值随着 xjx_j 的增加而减小。这与大多数空间建模意图相悖;不过,该模型在纯抑制性马尔可夫点过程中也有应用(参见 Besag,1976)。

13.4 本征自回归

如果 式(13.2) 的高斯条件自回归和 式(13.3) 的精度矩阵 Q\mathbf{Q} 仅是半正定的,并且秩 rank⁡(Q)<n\operatorname{rank}(\mathbf{Q}) < n ,则为 本征高斯自回归。

例如,如果定义 βij=wij/wi+\beta_{ij} = w_{ij}/w_{i+}、κi=κwi+\kappa_i = \kappa w_{i+}, 其中 κ>0\kappa>0 为精度参数,wij≥0w_{ij} \geq 0 为预定义权重,且 wi+=∑j≠iwijw_{i+} = \sum_{j \neq i} w_{ij},则此时的 Q\mathbf{Q} 是秩亏的矩阵。这种权重形式在区域数据的空间模型中非常常见。例如,如果区域 ii 和 jj 相邻(通常表示为 i∼ji\sim j ),则基于邻接的权重为 wij=1w_{ij} = 1 ,否则为零。还有其他选择是基于区域质心之间的距离倒数或公共边界长度定义权重。

对基于邻接矩阵的权重,条件均值和方差可以简化为:

E(Xi∣x−i)=∑j∈∂ixj/miVar⁡(Xi∣x−i)=(κ⋅mi)−1\begin{align*} &\mathbb{E}( X_i |\mathbf{x}_{-i} ) = \sum_{j \in \partial i} x_j /m_i\\ &\operatorname{Var}( X_i |\mathbf{x}_{-i} ) = (\kappa \cdot m_i )^{-1} \end{align*}

这里 mim_i 表示区域 ii 的邻居数,即集合 ∂i\partial i 的基数。

根据上述条件得到的联合分布是不适当的,它的密度可以写成:

p(x∣κ)∝exp⁡(−κ2∑i∼j(xi−xj)2)!−−swig0−−>(<)p(\mathbf{x} |\kappa) \propto \exp \left (− \frac{\kappa}{2} \sum\limits_{i\sim j} (x_i − x_j)^2 \right ) \tag13.9

其中求和遍历所有成对的相邻区域 i∼ji \sim j 。如 Besag、Green、Higdon 和 Mengersen (1995) 所述,这是 成对差先验 的一个特例。对于 x=(x1,…,xn)⊤\mathbf{x} = (x_1,\ldots ,x_n)^{\top} ,式(13.9) 的密度可以写成

p(x∣κ)∝exp⁡(−κ2x⊤Rx)p(\mathbf{x}|\kappa) \propto \exp \left( − \frac{\kappa}{2} \mathbf{x}^{\top} \mathbf{R} \mathbf{x}\right)

其中 R\mathbf{R} 是 结构矩阵,元素值定义为:

Rij={miifi=j,−1ifi∼j0otherwise.R_{ ij } = \begin{cases} m_i & \text{if} \quad i = j,\\ −1 & \text{if} \quad i \sim j\\ 0 &otherwise. \end{cases}

可以看出,精度矩阵 Q=κR\mathbf{Q} = \kappa \mathbf{R} 不能满秩,因为 R\mathbf{R} 的所有行和和列和均为零。

在索引 i=1,…,ni = 1,\ldots ,n 表示时间,且每个时间点有两个(分别一个)近邻时间点的特殊情况下,式(13.9) 的联合分布简化为:

p(x∣κ)∝exp⁡(−κ2∑i=2n∑i=2n(xi−xi−1)2)p(\mathbf{x}|\kappa) \propto \exp ( − \frac{\kappa}{2}\sum\limits^{n}_{i=2} \sum^n_{i=2} (x_i − x_{i-1})^2)

这就是所谓的一阶随机游走模型,因为它对应于在 x1x_1 上具有不适当均匀先验的有向形式

Xi∣xi−1∼N(xi−1,κ−1)X_i |x_{i-1} \sim \mathcal{N}(x_{i-1}, \kappa^{-1})

显然这是模型 式(13.6) 在 α=1\alpha = 1 时的极限情况。该模型的结构矩阵具有特别简单的形式:

R=(1−1−12−1−12−1⋱⋱⋱−12−1−12−1−11)(13.11)R= \begin{pmatrix} 1 & −1 & & & & &\\ −1 & 2 & −1 & & & \\ & −1 &2 &−1\\ & & \ddots & \ddots & \ddots & \\ & & & −1 & 2 & −1 &\\ & & & & −1 & 2 & −1\\ & & & & & −1 & 1 \end{pmatrix} \tag{13.11}

该结构是一些规则网格上的空间模型的基础,我们稍后会看到。

本征自回归比普通(适当的)条件自回归更难研究。例如,精度矩阵秩不足的问题,导致无法计算自相关函数。类似地,如果不施加额外的约束也无法从本征自回归中进行采样,因此本征自回归模型不能用于数据模型。在无限规则网格上,我们可以使用广义谱密度来研究本征自回归(详细信息参见 Besag 和 Kooperberg,1995 年;Künsch,1987 年)。

13.4.1 归一化本征自回归

本征高斯自回归的一个有趣命题是 “归一化常数”。该常数依赖于精度矩阵 Q\mathbf{Q} 中的某些未知参数,并且对于从数据中估计这些参数非常重要。当然,由于本征高斯自回归是不适当的,所以当 Q\mathbf{Q} 非正定时,不存在用于归一化如下密度的常数。

p(x∣κ)∝exp⁡(−12x⊤Qx)(13.12)p(\mathbf{x}|\kappa) \propto \exp ( − \frac{1}{2} \mathbf{x}^{\top} \mathbf{Qx}) \tag{13.12}

术语 “归一化常数” 必须在更一般的意义上被理解为等效的低维适当高斯分布的归一化常数。

现在大家普遍接受(Hodges、Carlin 和 Fan,2003 年;Knorr-Held,2003 年;Rue 和 Held,2005 年):对于 式(13.12) 模型中秩为 n−kn − k 的 n×nn × n 精度矩阵 Q\mathbf{Q} ,其正确的 “归一化常数” 为:

(2π)−(n−k)/2(∣Q∣∗)1/2(2\pi )^{−(n−k)/2}(|\mathbf{Q}|^*)^{1/2}

其中 ∣Q∣∗|Q|^* 表示 Q\mathbf{Q} 的 广义行列式 ,即 Q\mathbf{Q} 的 n−kn − k 个非零特征值的乘积.

在 式(13.10) 模型中的 Q=κR\mathbf{Q} = \kappa \mathbf{R} 时(结构矩阵 R\mathbf{R} 已知),由于 R\mathbf{R} 的秩为 n−kn − k,“归一化常数” 可以简化为

(k2π)n−k2\binom{k}{2 \pi} ^{\frac{n-k}{2}}

如果邻居结构不可分离,即所有像素都通过某个邻居链相互连接,则 k=1k = 1 。

13.4.2 例子

假设观测到数据 yi,i=1,…,ny_i , i = 1,\ldots ,n 并且我们假设

yi∣xi,σ2∼N(xi,σ2)(13.14)y_i |x_i , \sigma^2 \sim \mathcal{N}(x_i , \sigma^2) \tag{13.14}

以已知方差 σ2\sigma^2 条件独立。进一步假设,以 κ\kappa 为条件,未知平均曲面 x=(x1,…,xn)⊤\mathbf{x} = (x_1,\ldots ,x_n)^{\top} 遵循具有不可分离邻域结构的成对差分先验(公式 13.9)。目标是从 y\mathbf{y} 推断 x\mathbf{x} ,以便对观测到的 “图像” y\mathbf{y} 进行去噪并获得更平滑的版本。完全贝叶斯分析会在 κ\kappa 上放置超先验,通常是共轭伽马先验 κ∼G(α,β)\kappa \sim G(\alpha, \beta) ,即

f(κ)∝κα−1exp⁡(−βκ)f(\kappa) \propto \kappa^{\alpha−1}\exp(−\beta\kappa)

要实现两级吉布斯采样器(参见,例如,Gelfand 和 Smith,1990),可以从 x∣κ,y\mathbf{x} |\kappa, \mathbf{y} 和 κ∣x,y=κ∣x\kappa|\mathbf{x, y} = \kappa| \mathbf{x} 中采样。请注意, R\mathbf{R} 的秩为 n−1n − 1 ,因为假定图形不可分,因此根据 式(13.9) 和 式(13.13) ,可以得出

κ∣x∼G(α+n−12,β+12∑i∼j(xi−xj)2)\kappa|\mathbf{x} \sim G \left (\alpha + \frac{n − 1}{ 2} ,\beta + \frac{1}{2} \sum\limits_{i \sim j} (x_i − x_j )^2 \right )

另一个完全条件分布是

x∣κ,y∼N(Aa,A)\mathbf{x}|\kappa, \mathbf{y} \sim \mathcal{N}(\mathbf{Aa, A})

其中 A=(κR+σ2I)−1\mathbf{A} = (\kappa \mathbf{R} + \sigma^2 \mathbf{I})^{-1} 且 a=σ2y\mathbf{a} = \sigma^2 \mathbf{y} 。

请注意,不需要在 式(13.14) 中包含截距,因为本征自回归 x\mathbf{x} 具有未定义的总体水平。一个等效的公式是包括一个额外的截距和一个平坦的先验,并在 x\mathbf{x} 上使用一个额外的和为零的约束。另请注意,省略数据误差(即设置 σ2=0\sigma^2 = 0 )是没有用的,因为 xix_i 将等于 yiy_i ,并且不会进行平滑处理。

13.4.3 规则网格的本征自回归

我们现在回到在常规数组上定义的条件自回归。当将模型 式(13.8) 拟合到数据时,估计系数通常接近奇点(即 α+β\alpha + \beta 将接近 0.50.5 )以获得不可忽略的空间自相关。如果 α+β=0.5\alpha + \beta = 0.5 ,则获得模型 式(13.8) 的极限情况。例如,如果 α=β=0.25\alpha = \beta = 0.25 ,则 xijx_{ij} 的条件均值是

E(xij∣x−ij)=14(xi−1,j+xi+1,j+xi,j−1+xi,j+1)\mathbb{E}(x_{ij}|\mathbf{x}_{-i}j) = \frac{1}{4} (x_{i-1,j} + x_{i+1,j} + x_{i, j−1} + x_{i, j+ 1})

这是一个本征的自回归和条件方差等于 1/(4κ)1/(4\kappa) 的 式(13.9) 成对差异先验的特例。

然而,在常规阵列上,可以定义各向异性本征模型,该模型能够对水平和垂直邻居进行不同的加权。此扩展模型中的条件均值仍由 式(13.8) 给出,但现在允许系数 α>0\alpha>0 和 β>0\beta>0 随 α+β=0.5\alpha + \beta = 0.5 变化。条件方差仍然等于 1/(4κ)1/(4\kappa) 。此规范定义了有效的本征自回归。在应用中, α\alpha (或 β\beta )可作为未知参数处理,因此可以从数据中估计各向异性的程度。

要估计 α\alpha ,有必要计算相关精度矩阵 Q\mathbf{Q} 的广义行列式,它可以写成两个 Kronecker 乘积的和:

Q=αRn1⊗In2+βIn1⊗Rn2Q = \alpha \mathbf{R}_{n_1} \otimes \mathbf{I}_{n_2} + \beta \mathbf{I}_{n_1} \otimes \mathbf{R}_{n_2}

这里 Rn\mathbf{R}_n 是 nn 维随机游走模型的结构矩阵 式(13.11) , In\mathbf{I}_n 是 n×nn × n 单位矩阵。可以在 Rue and Held, 2005, p.107. 中找到广义行列式的明确形式。

13.4.4 高阶本征自回归

到目前为止,所有本征自回归都是一阶的,因为精度矩阵 Q\mathbf{Q} 的秩不足为 11 。这是由于 x\mathbf{x} 分布的总体水平未定义。如果将 x\mathbf{x} 替换为 μ+x\mu + \mathbf{x} ,则获得等效表示,其中 x\mathbf{x} 具有如上所述的密度,但在附加的和为零约束下,并且标量 μ\mu 具有不适当的局部均匀先验。在具有多个本征自回归的更复杂的层次模型中,这种总和为零的约束对于确保适当的后验是必要的。在线性约束下从 GMRF 采样的计算例程在这种情况下对于 MCMC 模拟特别有用(详见第 12 章)。

也可以考虑更高阶的本征自回归。例如,在规则格上,可以使用最近的八个或十二个最近的邻居来定义此类自回归。但是,必须谨慎选择合适的权重。从基于平方增量的(不适当的)联合高斯分布开始是很有用的,类似于先验平方差(式 (13.9_),并从联合分布中推导出完整的条件。例如,人们可能会考虑增量

∘∙∙∘−∙∘∘∙′(13.15)\begin{matrix} \circ &\bullet \\ \bullet &\circ \end{matrix} − \begin{matrix} \bullet &\circ \\ \circ &\bullet ' \end{matrix} \tag{13.15}

其中 ∙\bullet 进入差异,而不是 ∘\circ ,后者仅用于固定空间位置。对具有明确增量的所有像素求和, 式(13.15) 从而导致联合不当分布

p(x∣κ)∝exp⁡(−κ2∑i=1n1−1∑j=1n2−1(xi+1,j+1−xi+1,j−xi,j+1+xi,j)2)(13.16)p(\mathbf{x} |\kappa) \propto \exp \left (− \frac{\kappa}{2} \sum\limits^{n_1-1}_{i=1} \sum\limits^{n_2-1}_{j=1} (x_{i +1,j+1} − x_{i+1,j} − x_{i, j+1} + x_{i, j} )^2 \right ) \tag{13.16}

这是模型 式(13.10) 的一个特例,其中结构矩阵 R\mathbf{R} 定义为随机游动类型 式(13.11) 的两个结构矩阵 R1\mathbf{R}_1 和 R2\mathbf{R}_2 的克罗内克积,尺寸分别为 n1n_1 和 n2:R=κ⋅(R1⊗R2)n_2: \mathbf{R} = \kappa \cdot (\mathbf{R}_1 \otimes \mathbf{R}_2 )。 R\mathbf{R} 的秩为 (n1−1)(n2−1)(n_1 − 1)(n_2 − 1) ,因此 R\mathbf{R} 在 n1+n2−1n_1 + n_2 − 1 阶有不足

网格内部 xijx_{ij} 的条件均值 (2≤i≤n1−1,2≤j≤n2−1)(2 \leq i \leq n_1 − 1, 2 \leq j \leq n_2 − 1) 现在取决于它的八个最近的位置并且是

E(xij∣x−ij)=12(xi−1,j+xi+1,j+xi,j−1+xi,j+1)−14(xi−1,j−1+xi−1,j+1+xi+1,j−1+xi+1,j+1)\begin{align*} \mathbb{E}(x_{ij}|\mathbf{x}_{-ij}) &= \frac{1}{2} (x_{i −1,j} + x_{i+1,j} + x_{i, j−1} + x_{i, j+1})\\ &- \frac{1}{4}(x_{i-1,j−1} + x_{i-1,j+1} + x_{i+1, j−1} + x_{i+1,j+1}) \tag{13.17} \end{align*}

条件精度为 4κ4 \kappa 。在更紧凑的表示法中,条件均值是

E(xij∣x−ij)=12∘∙∘∙∘∙∘∙∘−14∙∘∙∘∘∘∙∘∙\mathbb{E}(x_{ij}|\mathbf{x}_{-ij}) = \frac{1}{2}\begin{matrix} \circ & \bullet & \circ \\ \bullet & \circ& \bullet\\ \circ& \bullet& \circ \end{matrix} − \frac{1}{4} \begin{matrix} \bullet &\circ &\bullet \\ \circ & \circ &\circ \\ \bullet & \circ & \bullet \end{matrix}

Künsch (1987) 中讨论了这种具有八个邻居的本征自回归的各向异性版本。

为了说明,我们现在描述如何从 式(13.16) 推导出条件均值 式(13.17) 。显然, p(xij∣x−ij,κ)∝p(x∣κ)p(x_{ij}|\mathbf{x}_{-ij}, \kappa) \propto p(\mathbf{x} |\kappa) ,因此在 式(13.16) 的双重求和中的四项在网格内部依赖于 xijx_{ij} ,因此,

p(xij∣x−ij,κ)∝exp⁡(−κ2((xi+1,j+1−xi+1,j−xi,j+1+xi,j)2+(xi+1,j−xi+1,j−1−xi,j+xi,j−1)2+(xi,j+1−xi,j−xi−1,j+1+xi−1,j)2+(xi,j−xi,j−1−xi−1,j+xi−1,j−1)2))\begin{align*} p(x_{ij}|\mathbf{x}_{−ij}, \kappa) \propto \exp &\Big( − \frac{\kappa}{2}((x_{i+1,j+1} − x_{i+1,j} − x_{i, j+1} + x_{i, j} )^2 \\ &+ (x_{i+1,j} − x_{i+1,j −1} − x_{i, j} + x_{i, j−1})^2 \\ &+ (x_{i, j+1} − x_{i, j} − x_{i-1,j+1} + x_{i-1,j})^2 \\ &+ (x_{i, j} − x_{i, j −1} − x_{i-1,j} + x_{i-1,j−1})^2 ) \Big) \end{align*}

可以重新排列为

p(xij∣x−ij,κ)∝exp⁡(−κ2((xi,j−(xi+1,j+xi,j+1−xi+1,j+1))2+(xi,j−(xi+1,j+xi,j−1−xi+1,j−1))2+(xi,j−(xi−1,j+xi,j+1−xi−1,j+1))2+(xi,j−(xi,j−1+xi−1,j−xi−1,j−1))2))\begin{align*} p(x_{ij}|\mathbf{x}_{-ij}, \kappa) \propto \exp &\Big ( − \frac{\kappa}{2} ( (x_{i, j} − (x_{i +1,j} + x_{i, j+1} − x_{i+1,j+1}))^2 \\ &+ (x_{i, j} − (x_{i+1,j} + x_{i, j−1} − x_{i+1,j−1}))^2 \\ &+ (x_{i, j} − (x_{i-1,j} + x_{i, j+1} − x_{i-1,j+1}))^2 \\ &+ (x_{i, j} − (x_{i, j−1} + x_{i-1,j} − x_{i− 1,j−1}))^2 ) \Big ) \end{align*}

结合二次型的恒最终给出(注:A(x−a)2+B(x−b)2=C(x−c)2+ABC(a−b)2其中C=A+B且c=(Aa+Bb)/CA(x − a )^2 + B(x − b)^2 = C(x − c)^2 + \frac{AB}{C} (a − b)^2 \quad \text{其中} \quad C = A + B \quad \text{且} \quad c = ( Aa + Bb)/C ):

p(xij∣x−ij,κ)∝exp⁡(−4κ2(xi,j−(12(xi−1,j+xi+1,j+xi,j−1+xi,j+1)−14(xi−1,j−1+xi−1,j+1+xi+1,j−1+xi+1,j+1)))2)\begin{align*} p(x_{ij}|\mathbf{x}_{-ij}, \kappa) \propto \exp &\Big( − \frac{4\kappa}{2} \Big( x_{i, j} − \Big(\frac{1}{2} (x_{i-1,j} + x_{i+1,j} + x_{i, j −1} + x_{i, j+1})\\ &− \frac{1}{4}(x_{i-1,j−1} + x_{i-1,j+1} + x_{i+1,j−1} + x_{i+1,j+1} ) \Big) \Big)^2 \Big) \tag{13.18} \end{align*}

从中可以得出条件均值 式(13.17) 和条件 4κ4\kappa 精度。

很容易看出分布 式(13.16) 对于任意行或列添加任意常数是不变的。这个特征使得这个分布不适合作为平滑变化表面的先验,这个缺陷可以通过扩展邻居系统来弥补。实际上,现在考虑联合分布

p(x∣κ)∝exp⁡(−κ2∑i=2n1−1∑j=2n2−1(xi−1,j+xi+1,j+xi,j−1+xi,j+1−4xi,j)2)p(\mathbf{x} |\kappa) \propto \exp \left (− \frac{\kappa}{2} \sum\limits^{ n_1 −1}_{i=2} \sum\limits^{n_2 −1}_{j =2} (x_{i-1,j} + x_{i+1,j} + x_{i, j −1} + x_{i, j+1} − 4x_{i, j})^2 \right )

基于增量

∘∙∘∙∘∙∘∙∘−4∘∘∘∘∙∘∘∘∘\begin{matrix} \circ & \bullet & \circ \\ \bullet & \circ & \bullet \\ \circ & \bullet & \circ \end{matrix} − 4 \begin{matrix} \circ & \circ & \circ \\ \circ & \bullet & \circ \\ \circ & \circ & \circ \end{matrix}

条件均值

E(xij∣x−ij)=820(xi−1,j+xi+1,j+xi,j−1+xi,j+1)−110(xi−1,j−1+xi−1,j+1+xi+1,j−1+xi+1,j+1)−120(xi−2,j+xi+2,j+xi,j−2+xi,j+2)\begin{align*} \mathbb{E}(x_{ij}|\mathbf{x}_{-ij}) = &\frac{8}{20} (x_{i-1,j} + x_{i+1,j} + x_{i, j−1} + x_{i, j+1})\\ &− \frac{1}{10} (x_{i-1,j−1} + x_{i-1,j+1} + x_{i+1,j−1} + x_{i+1,j+1})\\ &− \frac{1}{20} (x_{i−2,j} + x_{i+2,j} + x_{i, j−2} + x_{i, j +2}) \end{align*}

可以针对晶格内部的像素导出 (3≤i≤n1−2,3≤j≤n2−2)(3 \leq i \leq n_1 − 2, 3 \leq j \leq n_2 − 2) 。因此,在我们的紧凑符号中,条件均值是

E(xij∣x−ij)=120(8∘∘∘∘∘∘∘∙∘∘∘∙∘∙∘∘∘∙∘∘∘∘∘∘∘−2∘∘∘∘∘∘∙∘∙∘∘∘∘∘∘∘∙∘∙∘∘∘∘∘∘−1∘∘∙∘∘∘∘∘∘∘∙∘∘∘∙∘∘∘∘∘∘∘∙∘∘)\mathbb{E}(x_{ij} | \mathbf{x}_{−ij}) = \frac{1}{20} \left ( 8 \quad \begin{matrix} \circ & \circ & \circ & \circ & \circ \\ \circ & \circ & \bullet & \circ & \circ \\ \circ & \bullet & \circ & \bullet & \circ \\ \circ & \circ & \bullet & \circ & \circ \\ \circ & \circ & \circ & \circ & \circ \end{matrix} −\quad 2 \quad \begin{matrix} \circ & \circ & \circ & \circ & \circ \\ \circ & \bullet & \circ & \bullet & \circ\\ \circ & \circ & \circ & \circ & \circ \\ \circ & \bullet & \circ & \bullet & \circ \\ \circ & \circ & \circ & \circ & \circ \end{matrix} −\quad 1 \quad \begin{matrix} \circ & \circ & \bullet & \circ & \circ \\ \circ & \circ & \circ & \circ & \circ\\ \bullet & \circ & \circ & \circ & \bullet \\ \circ & \circ & \circ & \circ & \circ\\ \circ & \circ & \bullet & \circ & \circ \end{matrix} \right )

条件方差为 1/(20κ)1/(20\kappa) ,而在网格的边界上需要对均值和方差进行适当修改(有关详细讨论,请参见 Rue 和 Held,2005 年)。还考虑了各向异性版本 (Künsch, 1987)。

这种条件自回归基于每个像素的 1212 个最近邻。分布 式(13.19) 对于线性变换 xij→xij+pijx_{ij} \rightarrow x_{ij} + p_{ij} 是不变的,其中 pij=γ0+γ1i+γ2jp_{ij} = \gamma_0 + \gamma_1 i + \gamma_2 j 对于任意系数 γ0\gamma_0 、 γ1\gamma_1 和 γ2\gamma_2 。这是一个有用的属性,因为先验常用于平滑二维线性趋势 pijp_{ij} 的偏差的应用程序中。

然而,该模型有一些缺点。首先,四个角 x1,1x_{1,1} , x1,n2x_{1,n_2} , xn1,1x_{n_1,1} , xn1,n2x_{n_1,n_2} 没有出现在 式(13.19) 中。其次,作为对微分算子的差分逼近,模型(13.19)引入了所谓的各向异性离散化误差,即沿对角线的逼近误差大于水平或垂直方向(有关此问题的详细信息,请参见Rue and Held,2005 年第 117 页)。

一个更精细的模型由

p(x∣κ)∝exp⁡(−κ2∑i=2n1−1∑j=2n2−1(23(xi−1,j+xi+1,j+xi,j−1+xi,j+1)+16(xi−1,j−1+xi−1,j+1+xi+1,j−1+xi+1,j+1)−103xi,j)2)\begin{align*} p(\mathbf{x} |\kappa) \propto \exp &\Big (− \frac{\kappa}{2} \sum\limits^{n_1-1}_{i=2} \sum\limits^{n_2-1}_{j=2} \Big( \frac{2}{3} (x_{i-1,j} + x_{i+1,j} + x_{i, j−1} + x_{i , j+1}) \\ &+ \frac{1}{6} (x_{i-1,j−1} + x_{i-1,j+1} + x_{i+1,j−1} + x_{i+1,j+1}) −\frac{10}{3}x_{i, j} \Big)^2 \Big) \tag{13.20} \end{align*}

基于如下步进:

23∘∙∘∙∘∙∘∙∘+16∙∘∙∘∘∘∙∘∙−103∘∘∘∘∙∘∘∘∘\frac{2}{3}\quad \begin{matrix} \circ \bullet \circ \\ \bullet \circ \bullet \\\circ \bullet \circ \end{matrix}+ \frac{1}{6} \quad \begin{matrix} \bullet \circ \bullet \\ \circ \circ \circ \\ \bullet \circ \bullet \end{matrix} − \frac{10}{3} \quad \begin{matrix} \circ \circ \circ \\ \circ \bullet \circ \\ \circ \circ \circ \end{matrix}

请注意,四个角: x1,1x_{1,1} , x1,n2x_{1,n_2} , xn1,1x_{n_1,1} , xn1,n2x_{n_1,n_2}。

现在进入联合分布。 xijx_{ij} 的完全条件依赖于 2424 个邻居,其条件期望为

E(xij∣x−ij)=1468(144∘∘∘∘∘∘∘∙∘∘∘∙∘∙∘∘∘∙∘∘∘∘∘∘∘−18∘∘∙∘∘∘∘∘∘∘∙∘∘∘∙∘∘∘∘∘∘∘∙∘∘+8∘∘∘∘∘∘∙∘∙∘∘∘∘∘∘∘∙∘∙∘∘∘∘∘∘−8∘∙∘∙∘∙∘∘∘∙∘∘∘∘∘∙∘∘∘∙∘∙∘∙∘−1∙∘∘∘∙∘∘∘∘∘∘∘∘∘∘∘∘∘∘∘∙∘∘∘∙)\begin{align*} \mathbb{E}(x_{ij} | \mathbf{x}_{−ij}) = &\frac{1}{468} \Big ( 144 \quad \begin{matrix} \circ \circ \circ \circ \circ \\ \circ \circ \bullet \circ \circ \\ \circ \bullet \circ \bullet \circ \\ \circ \circ \bullet \circ \circ \\ \circ \circ \circ \circ \circ \end{matrix} − \quad 18 \quad \begin{matrix} \circ \circ \bullet \circ \circ \\\circ \circ \circ \circ \circ \\\bullet \circ \circ \circ \bullet \\\circ \circ \circ \circ \circ \\\circ \circ \bullet \circ \circ \end{matrix}\\ &+ \quad 8 \quad \begin{matrix} \circ \circ \circ \circ \circ \\ \circ \bullet \circ \bullet \circ \\\circ \circ \circ \circ \circ \\ \circ \bullet \circ \bullet \circ \\\circ \circ \circ \circ \circ \end{matrix}− \quad 8 \quad \begin{matrix} \circ \bullet \circ \bullet \circ \\ \bullet \circ \circ \circ \bullet \\\circ \circ \circ \circ \circ \\ \bullet \circ \circ \circ \bullet \\ \circ \bullet \circ \bullet \circ \end{matrix}− \quad 1 \quad \begin{matrix} \bullet \circ \circ \circ \bullet \\\circ \circ \circ \circ \circ \\ \circ \circ \circ \circ \circ \\\circ \circ \circ \circ \circ \\\bullet \circ \circ \circ \bullet \end{matrix}\Big) \end{align*}

条件方差为 1/(13κ)1/(13\kappa) (有关详细信息,请参阅 Rue 和 Held,2005 年)。

13.5 多元高斯条件自回归

多元高斯条件自回归是 式(13.2) 和 式(13.3) 的直接推广。假设 XiX_i , i=1,…,nii = 1,\ldots ,n_i 是一个 pp 维随机向量,并设 XiX_i 给定 x−i\mathbf{x} _{-i} 的条件分布是具有如下条件均值和协方差矩阵的多元高斯分布

E(Xi∣x−i)=μi+∑j≠iBij(xj−μj)(13.21)\mathbb{E}(\mathbf{X}_i |\mathbf{x}_{-i}) = \boldsymbol{\mu}_i + \sum\limits_{ j \neq i} \mathbf{B}_{ij}(\mathbf{x}_j − \boldsymbol{\mu}_j ) \tag{13.21}

Cov⁡(Xi∣x−i)=Φi−1(13.22)\operatorname{ Cov}(\mathbf{X}_i |\mathbf{x}_{-i} ) = \mathbf{\Phi}^{-1}_i \tag{13.22}

矩阵 Bij\mathbf{B}_{ij} 和 Φi>0\boldsymbol{\Phi}_i > 0 都是维度 p×pp× p 。不失一般性,我们假设 μ1=…=μn=0\boldsymbol{\mu}_1 =\ldots=\boldsymbol{\mu} _n = \mathbf{0} 。在单变量情况下, X=(X1,…,Xn)\mathbf{X} = (\mathbf{X}_1,\ldots , \mathbf{X}_n) 的联合分布是多元高斯分布,均值为 0\mathbf{0} ,精度为矩阵 Q=D(I−B)\mathbf{Q = D(I − B)},前提是 Q\mathbf{Q} 是规则对称的 (Mardia, 1988)。在这里, D\mathbf{D} 是块对角线,元素为 Φi,i=1,…,n\boldsymbol{\Phi}_{i,i} = 1,\ldots ,n, I\mathbf{I} 是单位矩阵, B\mathbf{B} 是 np×npnp × np ,块元素 Bij\mathbf{B}_{ij} 对于 i≠ji \neq j ,块对角线元素为零。有关此模型的更多详细信息,请参阅 Banerjee 等 (2004 年,第 7.4.2 节)。

在实践中,我们经常遇到这样的情况,即我们在每个像素中都有多变量观测值,像素之间具有固定的邻域结构。基于邻接的本征成对差分先验( 13.9)的直接概括是13.23)

p(x∣Φ)∝exp⁡(−12∑i∼j(xi−xj)⊤Φ(xi−xj))(13.23)p(\mathbf{x}|\boldsymbol{\Phi}) \propto \exp \left (− \frac{1}{2} \sum\limits_{ i \sim j} (\mathbf{x}_i − \mathbf{x}_j )^{\top} \boldsymbol{\Phi} (\mathbf{x}_i − \mathbf{x}_j ) \right) \tag{13.23}

条件均值和协方差矩阵等于

E(Xi∣x−i)=∑j∼ixj/mi\mathbb{E}(X_i |\mathbf{x}_{-i} ) = \sum\limits_{j \sim i} \mathbf{x}_j /m_i

Cov⁡(Xi∣x−i)=(mi⋅Φ)−1\operatorname{ Cov}(\mathbf{X}_i |\mathbf{x}_{-i} ) = (m_i \cdot \boldsymbol{\Phi})^{-1}

Gelfand 和 Vounatsov (2003) 更详细地讨论了多元条件自回归模型(另请参见 Banergee 等人,2004 年的第 7.4 节)